BSc-Dissertation · AI / Machine Learning
Cybersecurity Incident Classification — NLP, ML & MITRE ATT&CK
Forschung und Evaluation einer AI-gestützten Pipeline zur Klassifikation von Cybersecurity Incidents mit Text-Features, Transformer-Embeddings, strukturierten Security-Metadaten und Ensemble-Modellen.
BSc-Dissertation / ForschungsprojektKontext & Umfang
Dieses Projekt entstand im Rahmen meiner BSc-(Hons)-Cyber-Security-Dissertation. Es untersucht, wie NLP- und Machine-Learning-Methoden die Klassifikation und Triage von Security Incidents unterstützen können. Es handelt sich um einen Forschungsprototyp und nicht um eine produktive SOC-Automatisierungsplattform.
Ziel
Entwicklung und Evaluation einer reproduzierbaren Incident-Classification-Pipeline, die textuelle und strukturierte Security-Features kombiniert, mehrere Machine-Learning-Modelle vergleicht und deren mögliche Relevanz für Security-Triage-Workflows untersucht.
Forschungsansatz
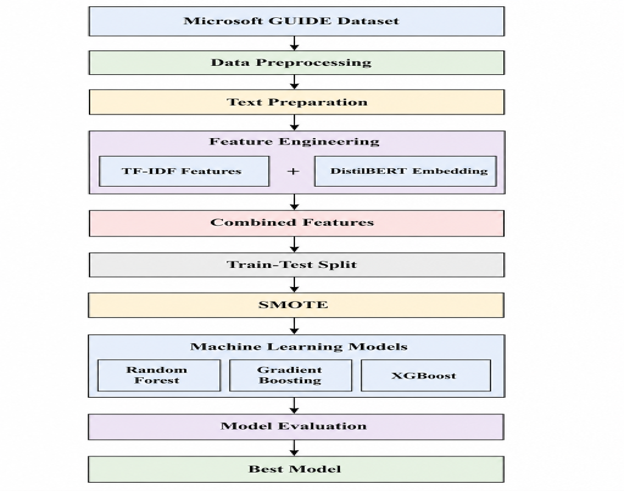
- Aufbereitung eines Forschungsdatensatzes mit 50.000 Cybersecurity-Incident-Datensätzen aus dem Microsoft-GUIDE-Dataset.
- Kombination von TF-IDF-Textrepräsentationen, Sentence-Transformer-Embeddings und strukturierten Security-Metadaten in einer hybriden Feature-Pipeline.
- Einsatz von SMOTE im experimentellen Workflow zur Behandlung von Klassenungleichgewicht.
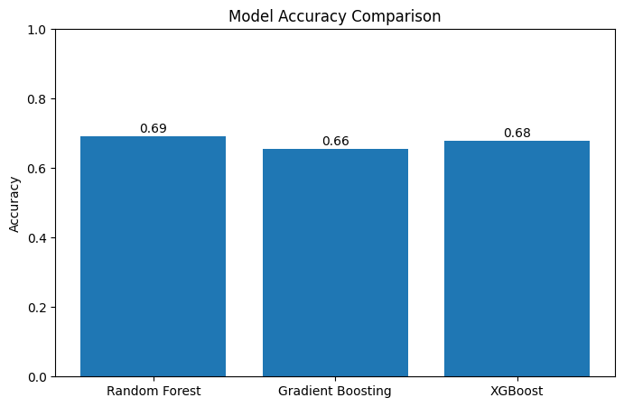
- Vergleich von Random Forest, Gradient Boosting und XGBoost.
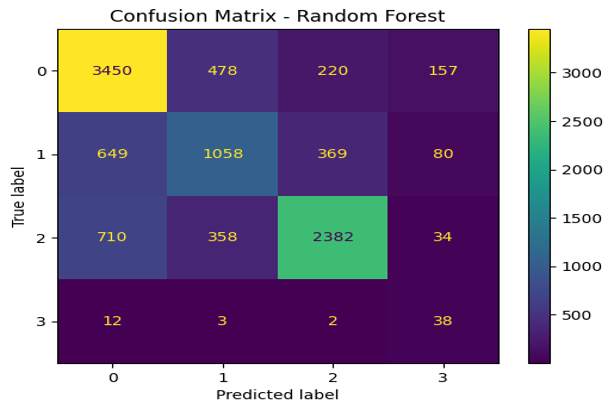
- Bewertung des Modellverhaltens mit Accuracy, Weighted F1-Score, Cross-Validation, Confusion Matrices, ROC-Analyse, Precision-Recall-Analyse und Feature Importance.
- Nutzung von MITRE-ATT&CK-Kontext zur Security-orientierten Interpretation von Incident-Kategorien und Modellergebnissen.
Wichtige Ergebnisse
- Der experimentelle Datensatz umfasste 50.000 Security-Incident-Datensätze.
- Die entwickelte hybride Repräsentation umfasste 694 Features.
- Drei Ensemble-Machine-Learning-Klassifikatoren wurden evaluiert.
- Random Forest erzielte mit 69,28 % die höchste berichtete Test-Accuracy.
- Random Forest erreichte einen Weighted F1-Score von 0,6963.
- Die berichtete Cross-Validation-Accuracy des stärksten Modells lag bei 75,96 %.
Forschungsevidenz
Ausgewählte Abbildungen aus dem ursprünglichen BSc-Dissertationsexperiment. Die Ergebnisse repräsentieren Forschungsevaluation und keine produktive SOC-Performance.
Forschungsgrenze
Die Ergebnisse stammen aus einer akademischen Forschungspipeline, die auf einem aufbereiteten Datensatz evaluiert wurde. Sie belegen keine produktive Implementierung, autonome SOC-Entscheidungen oder operative Performance bei realen Enterprise-Incidents.
Security-Relevanz
Das Projekt demonstriert Security-Datenaufbereitung, NLP-Feature-Engineering, Transformer-basierte Repräsentationen, Behandlung von Klassenungleichgewicht, Modellvergleich, Performance-Evaluation, MITRE-ATT&CK-orientierte Analyse und kritische Bewertung AI-gestützter Security-Triage.